vLLM 官方博客 · 2026/10/15 08:00:00
NVIDIA Nemotron 3.5 Super VL 开源:120B MoE 多模态模型支持长程智能体视觉推理与工具调用
NVIDIA 发布开源多模态大模型 Nemotron 3.5 Super VL,专为长程智能体设计,集成文本、图像、文档及视频理解能力。该模型基于 120B 参数混合专家(MoE)架构,仅激活 12B 参数以平衡精度与效率,支持通过 NeMo 框架进行定制化后训练。vLLM 已实现 Day 0 支持,开发者可直接部署用于需要高精度视觉推理与工具调用的复杂工作流。
报道全文原始报道全文
本文目录10 个章节
始终在线的 Agent 日益需要解读视觉信息、进行跨模态推理、调用工具并执行操作。这些工作流要求模型兼具多模态理解能力与高精度执行能力。
NVIDIA Nemotron 3.5 Super VL 是一款开源、可定制的多模态模型,专为长期运行的 Agent 打造,助力开发者在特定工作流中实现精度与效率的最大化。
该模型将推理、指令遵循和工具使用能力与文本、图像、文档及视频理解融为一体,从而减少单独部署文本模型和视觉模型的需求,并有助于在整个工作流步骤中保持任务相关的上下文连贯性。
Nemotron 3.5 Super VL 基于拥有 1200 亿参数的混合专家(MoE)架构构建,激活参数为 120 亿,在面向特定任务的始终在线 Agent 场景中实现了精度与效率的平衡。组织可利用 NVIDIA NeMo,结合自身数据、工具、策略和工作流对其进行后训练。
在多模型系统中,Nemotron 3.5 Super VL 被设计为默认的高精度 Agentic 执行模型,原生支持文档、图像和视频理解。它与用于高吞吐量文本执行的 NVIDIA Nemotron 3.5 Lightning 以及用于处理最复杂纯文本推理任务的 NVIDIA Nemotron 3 Ultra 形成互补。
Nemotron 3.5 Super VL 解决了多模态、始终在线 Agent 的两个实际关键需求:
- 具备 Agentic 执行能力的原生视觉理解: 该模型将高精度推理和工具使用能力与文档、图像及视频理解相结合,在特定工作流中保持任务相关上下文的完整性。
- 高效且可控的部署: 采用 Mamba-Transformer 混合架构、多 Token 预测(multi-token prediction)以及 NVFP4 量化技术,旨在提升生成效率,并为更多并发长上下文会话预留资源空间。
TL;DR:关于 NVIDIA Nemotron 3.5 Super VL
-
架构: 采用混合专家(MoE)设计,总参数量为 120B,激活参数为 12B
-
模态: 输入支持文本、图像、文档和视频;输出为文本
-
优化: C-RADIOv4 视觉编码器、Mamba-Transformer 混合架构、多 Token 预测以及 NVFP4 量化
-
模型角色: 面向模型系统的高精度智能体执行,具备原生视觉理解能力
-
定制: 使用 NVIDIA NeMo,结合组织特定的数据、工具、策略和工作流进行后训练
-
部署: 通过 NVIDIA NIM 实现跨云和数据中心环境的优化生产服务
-
部署目标: 1x GB10、B200、B300、RTX PRO 6000、H200 和 2x H100
-
可用性:
-
使用 vLLM 运行 Nemotron 3.5 Super VL,参考入门指南
使用 vLLM 运行高吞吐量推理
Nemotron 3.5 Super VL 旨在广泛兼容各类 NVIDIA 平台。vLLM 提供了将模型引入生产工作流所需的服务层,包括连续批处理(continuous batching)、前缀缓存(prefix caching)、推测解码(speculative decoding)以及 OpenAI 兼容 API。
BF16 检查点为部署提供了直接的基线方案。NVFP4 在发布时也可用,适用于能够利用低精度推理的环境。
安装 vLLM
docker pull vllm/vllm-openai:v0.31.0

docker run --rm -it --gpus all --ipc=host --network=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --entrypoint /bin/bash \
  vllm/vllm-openai:v0.31.0
启动模型服务
以下 NVFP4 启动配置是针对 1× GB200 设置的示例。在使用前请在目标硬件上进行验证。
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --max-model-len 114688 \
  --reasoning-parser nemotron_v3 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 5
服务器运行后,应用程序可通过 OpenAI 兼容客户端发送提示词:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="null")

response = client.chat.completions.create(
    model="nemotron-3.5-super",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Describe what happens in this video."},
                {
                    "type": "video_url",
                    "video_url": {"url": "https://example.com/clip.mp4"}
                },
            ],
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=4096,
)

print(response.choices[0].message.reasoning)  # thinking trace
print(response.choices[0].message.content)    # final answer
通过推测解码加速长时间运行的智能体工作流
Nemotron 3.5 Super VL 支持多 Token 预测(MTP),在保持目标模型输出质量的同时加速 Token 生成。
Nemotron 3.5 Super VL 内置了多 Token 预测(MTP)头。在解码过程中,这些 MTP 头会提议未来的 Token,然后由目标模型进行验证,从而减少生成长响应所需的顺序生成步骤数量。
例如,可以通过启用三个推测性 Token 来使用 MTP:
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 3
专为专业化、始终在线的智能体工作流打造
组织可以使用 NVIDIA NeMo 将 Nemotron 3.5 Super VL 适配到其术语、数据、策略、工具和工作流中。这使得通用多模态模型能够转变为针对特定领域智能体任务的专业执行引擎,同时保留对模型行为和数据处理的控制权。
示例用例
- 客户服务: 通过解读客户提供的文档和图像、应用政策并使用服务工具来解决多步骤请求。
- 文档智能: 解读复杂文档——包括 OCR、表格、图表和页面布局——以提取信息并生成摘要或报告。
- 企业生产力: 通过解读视觉信息、对其进行推理并使用工具来完成多步骤任务。
- 视频理解: 从视频中提取关键信息,以支持搜索、内容审核、广告、零售和事件分析。
- 网络研究: 跨网站进行搜索,连接来自多个来源的信息并验证结果。
多模态智能体任务的准确性与效率
Nemotron 3.5 Super VL 旨在为专用多模态智能体任务提供高精度,同时在处理每个 token 时仅使用其总参数的一部分。混合 Mamba-Transformer 架构、多 token 预测以及 NVFP4 量化技术共同加速了输出生成。
如图 1 所示,在单 GPU 上,该模型在智能体任务中的吞吐量比同尺寸类别的其他开源模型最高快 5 倍。
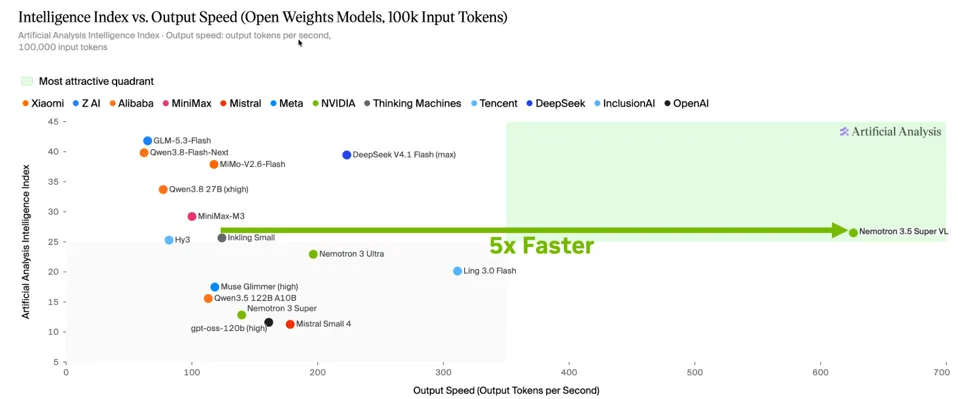
与其他开源模型相比,Nemotron 3.5 Super VL 在输入 100,000 个 token 的情况下,输出速度超过每秒 600 个 token。
图 1. Nemotron 3.5 Super VL 在 Baseten 端点上执行 Artificial Analysis Intelligence Index 智能体任务时,吞吐量超过 600 TPS。
如图 2 所示,与同等规模的其他领先开源模型相比,Nemotron 3.5 Super VL 执行任务的速度快 4 倍。
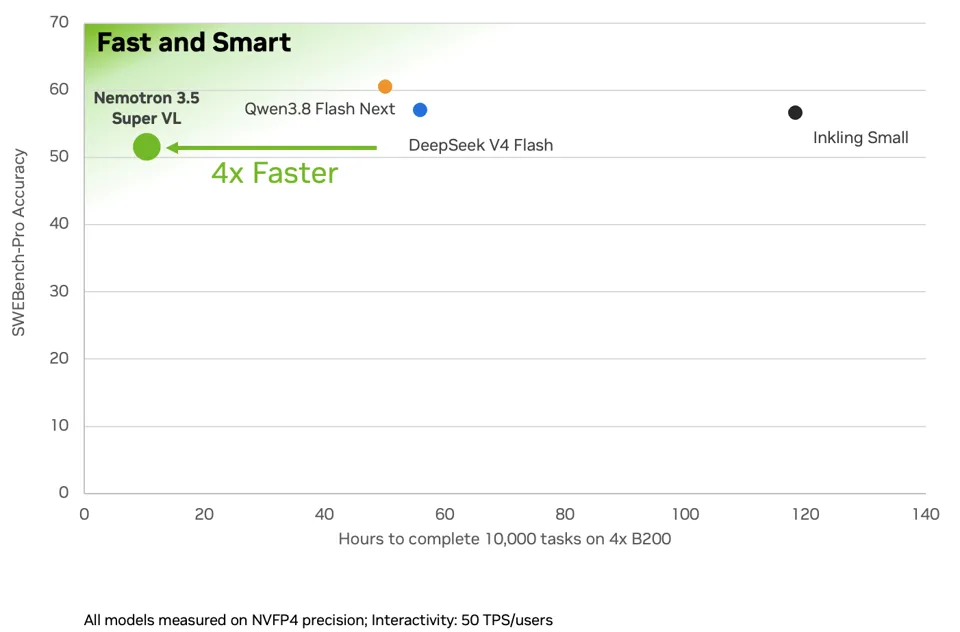
图表比较了在四块 B200 GPU 上完成 10,000 个任务的 SWE-bench Pro 准确率及耗时;Nemotron 3.5 Super VL 的完成时间最短。
图 2. Nemotron 3.5 Super VL 利用更高的吞吐量和 token 效率,实现了 4 倍更快的任务完成速度。
作为背景参考,图 3 展示了相关模型 Nemotron 3.5 Super 在 DGX Spark 上的对比情况。该图表并未测量 Nemotron 3.5 Super VL。
Nemotron 3.5 Super(与 Super VL 是不同的模型)在 local.ai 智能指数中得分为 80,在 DGX Spark 上每任务耗时 6.5 分钟。
图 3. Nemotron 3.5 Super 在 DGX Spark 效率前沿的表现。
开始使用
准备好构建能够感知、推理和行动的智能体了吗?
致谢
NVIDIA:Nirmal Kumar Juluru、Anusha Pant、Faradawn Yang、Pen Chung Li、Alex Steiner、Ran Zilberstein、Nave Assaf、Amir Klein