Artificial Analysis · 2026/10/7 08:00:00
Anthropic 发布 Claude Haiku 5.5:首推自适应思考与分级定价,小模型性能逼近开源 Kimi K3
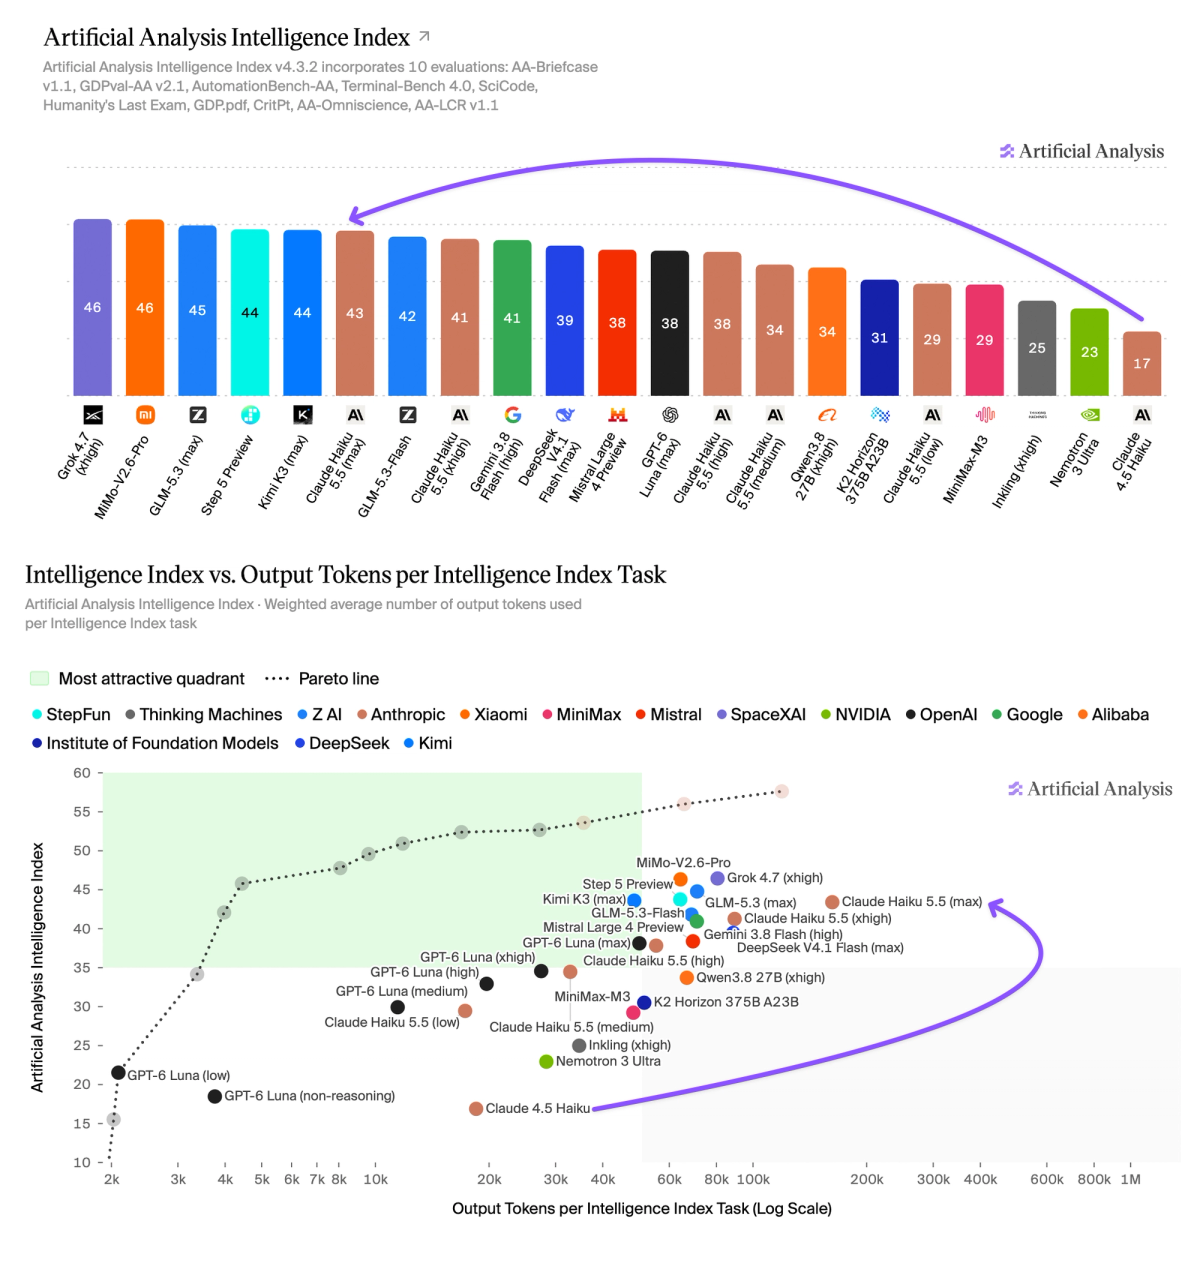
Anthropic 正式推出 Claude Haiku 5.5,这是首个支持努力程度设置(effort settings)和自适应思考功能的 Haiku 系列模型。该模型在保持极低输入成本($0.10/百万 token)的同时,其最大努力模式下的智能指数得分超越 Gemini 3.8 Flash 和 GPT-6 Luna,接近 2.8T 参数的开源模型 Kimi K3。然而,新模型引入了基于上下文长度的阶梯式定价机制,且在高强度推理任务中消耗的输出 token 数量约为竞品的三倍。
报道全文原始报道全文
Haiku 5.5 是首款支持 Anthropic 努力程度设置(effort settings)和自适应思考(adaptive thinking)的 Haiku 模型,同时 Anthropic 引入了分层定价策略。
Haiku 5.5 比其前代产品更便宜——对于不超过 10 万 token 的提示词,每百万输入/输出 token 的费用为 0.50(与 GPT-6 Luna 持平,仅为上一代 Haiku 模型的 10%)。然而,当上下文超过 10 万 token 时,价格将上涨 5 倍至 2.50。目前网站尚未体现分层定价,因此 Haiku 5.5 的临时成本数据未包含超额部分的阶梯费用。我们正在完善相关支持,并将很快跟进“每任务成本”(Cost per Task)的相关覆盖内容。
关键要点:
➤ 小尺寸模型中的性能领先者: 在最大努力程度(max effort)下,Haiku 5.5 的表现略优于 GLM-5.3 Flash (42)、Gemini 3.8 Flash (41) 和 GPT-6 Luna (38) 等模型。其得分与拥有 2.8T 参数的开放权重模型 Kimi K3 (44) 相当,但落后于 Claude Sonnet 5.5 (max, 56) 13 分
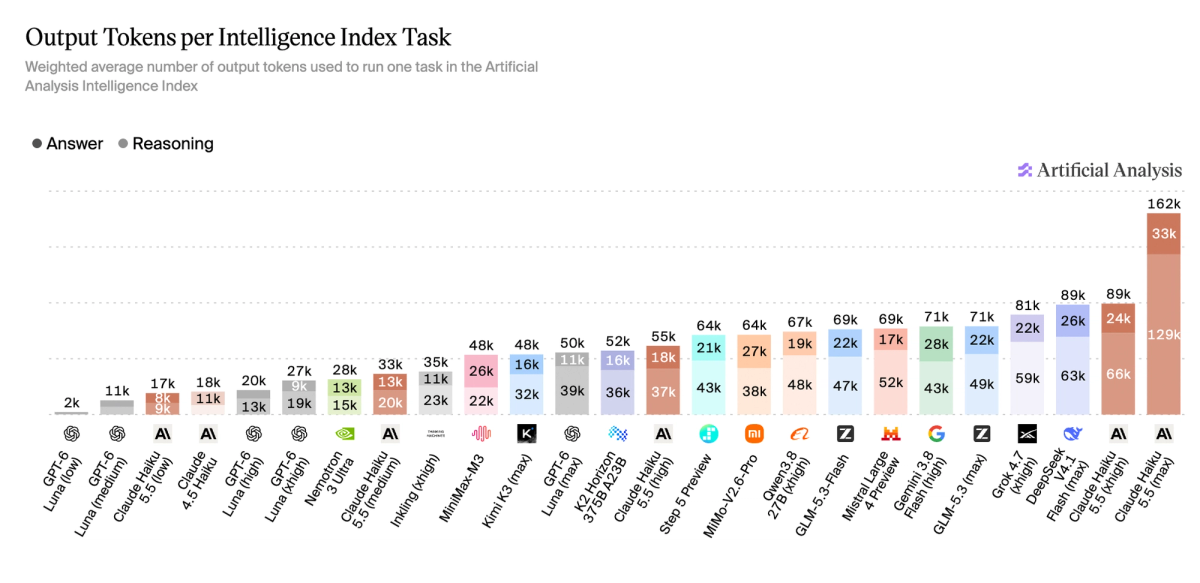
➤ 相比 GPT-6 Luna 更高的 Token 消耗: Haiku 5.5 (max) 在每个智能指数(Intelligence Index)任务中约使用 16.2 万输出 token,约为 GPT-6 Luna (max, ~5 万) 的 3 倍。从 xhigh 提升至 max 仅增加 2 分,但 Token 消耗量增加了约 1.8 倍。在相近的智能水平下,它也使用了更多的 Token:Haiku 5.5 (high) 得分为 38,每任务约使用 5.5 万 Token;而 Luna (max) 同样得分为 38,每任务仅使用约 5 万 Token,且在较低的努力程度设置下这一差距进一步扩大
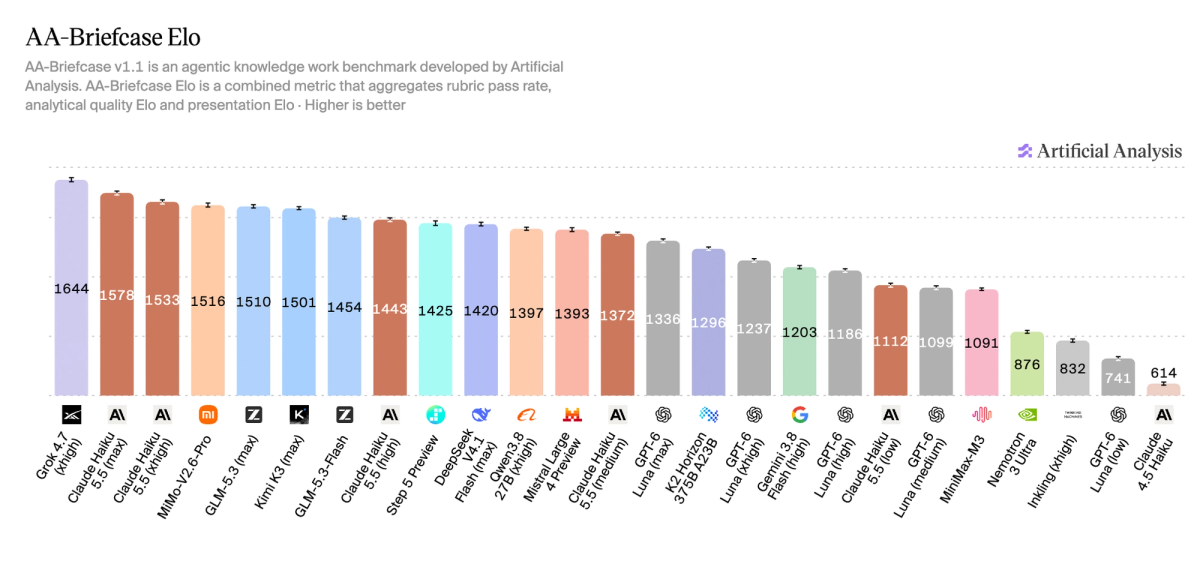
➤ 在代理式知识工作方面能力出色: 在 AA-Briefcase(我们针对现实知识工作任务进行的私有评估)中,Haiku 5.5 (max) 达到 1578 Elo,领先于包括 Kimi K3 和 GLM-5.3 在内的多个模型,并与 Muse Spark 1.3 (max) 表现相当
➤ 终端使用能力的提升: 在 Terminal-Bench 4.0 上,其得分为 33%,较 Haiku 4.5 的 0% 有显著提升。这一成绩与 GLM-5.3 Flash 持平,并领先于 Gemini 3.8 Flash (20%) 和 GPT-6 Luna (13%)
➤ 事实性知识较弱,但幻觉率相对较低: 作为较小尺寸的模型,Haiku 5.5 的事实性知识低于其同系列其他模型,这符合预期。AA-Omniscience 准确率为 36%,低于 Gemini 3.8 Flash 的 55% 和 GPT-6 Luna 的 44%,但这部分归因于它更愿意承认自己不知道答案——其幻觉率为 40%,低于后两者的 55% 和 77%
➤ AutomationBench-AA 结果可能被低估: Haiku 5.5 得分为 35%,而 GPT-6 Luna、Gemini 3.8 Flash 和 GLM-5.3 Flash 的得分在 53–60% 之间。在预发布测试期间,一个安全拒绝问题导致模型过度拒绝响应。Anthropic 正在着手解决此问题——我们将在修复后重新运行该评估,预计分数会有所提升
其他模型细节:
➤ 上下文窗口: 100 万 tokens,相比 Claude 4.5 Haiku 的 20 万 tokens 有所增加
➤ 定价: 输入/输出每百万 tokens 分别为 0.50(适用于前 10 万 tokens),超过部分为 2.50。缓存读取费用为 0.05),5 分钟缓存写入费用为 0.625)
➤ 多模态能力: 支持文本和图像输入,输出为文本
Claude Haiku 5.5 (max) 在每个 Intelligence Index 任务中消耗约 16.2 万输出 tokens,高于 Opus 5.5 (max),约为 GPT-6 Luna (max) 的 3 倍。在不同 effort 设置下,Haiku 5.5 需要比 GPT-6 Luna 更多的输出 tokens 才能达到相似的 Intelligence Index 分数
Claude Haiku 5.5 (max) 在 AA-Briefcase(我们私有的前沿知识工作评估基准)上达到 1578 Elo 分,处于 GPT-6 Astra (max) 和 Claude Fable 5.1 (high) 的置信区间内
Artificial Analysis Intelligence Index 中针对 Claude Haiku 5.5 在不同 effort 设置下的各项单独评估详细分解